SPECIMEN ID: R1-PURE-RL-2026
//
纯强化学习认知推理基座
deepseek
DeepSeek - 探索未至之境。在暮蓝琥珀的终端黑客秩序中,构建纯强化学习推理大模型。以长思维链自主纠错机制,开启认知智能全新坐标。
> INIT DEEPSEEK_REASONER_ENGINE
> STATUS: ALL_PIPELINES_SYNCHRONIZED
> REASONING_STREAM: ACTIVE
[RL-VERIFY]: 正在进行复杂数学命题自主假设与长思维链多路径搜索验证...
DeepSeek-R1 强化学习自省
不依赖大量人工标记与死记硬背先验,模型在纯强化学习环境中自发激发出多步自我纠错、反思检验的长逻辑推演链。
DeepSeek api开放平台
100% 兼容通用生态接口规范,以百倍算力性价比普惠全球科研人员,独家开放 reasoning_content 思维流实时订阅推送。
自动化评测套件
配套 DeepSeek Harness 自动化测试集,零误差复现 AIME 与 Codeforces 权威评测跑分。
本地多规格量化
开源 1.5B 至 671B 全系列蒸馏与基座权重,提供 FP8 与 INT4 极致压缩,适配单卡边缘部署。
探索未至之境
坚持技术无私开放,全量技术报告透明公开,践行科学探索平权与通用智能长久普惠愿景。
| EVALUATION DOMAIN | DeepSeek-R1 (纯强化学习) | Claude 3.5 Sonnet | GPT-4o |
|---|---|---|---|
| AIME 2024 (全美数学竞赛) | 79.8% (Top 1) | 16.0% | 13.4% |
| MATH-500 (综合高阶数学竞赛) | 97.3% (Top 1) | 78.3% | 74.6% |
| Codeforces (全球竞技编程段位) | 2029 (Percentile 96.3%) | 1600 | 1440 |
| MMLU (多学科通识理解) | 90.8% | 88.3% | 87.2% |
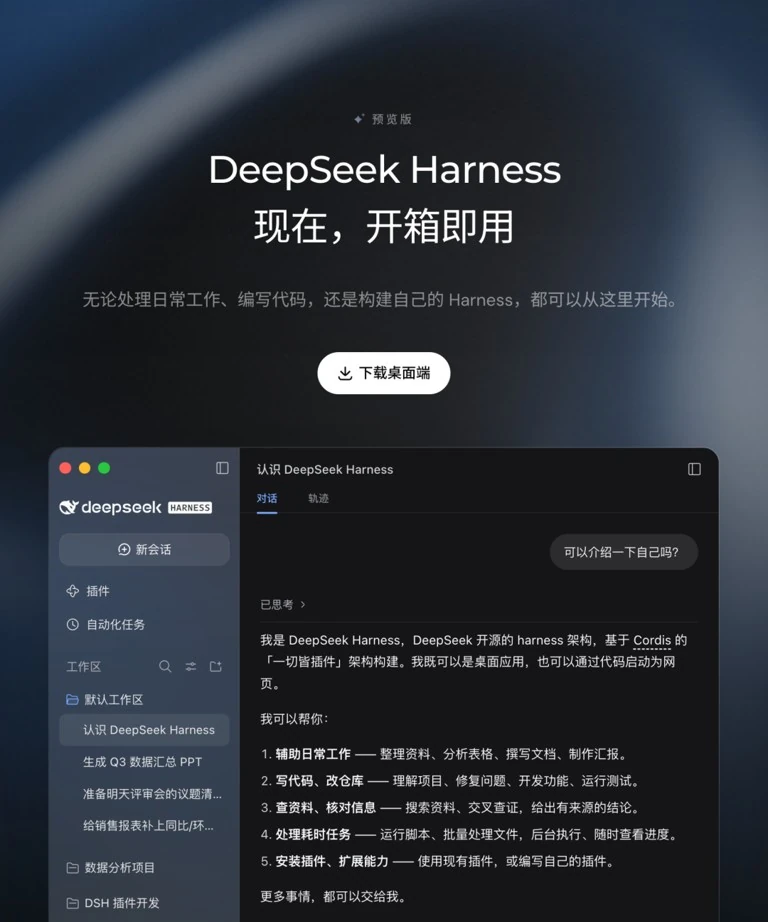
CLUSTER // HIGH-EFFICIENCY COMPUTING MESH
REASONING // LONG-CHAIN MULTI-STEP SOLVER